 15+ Jahre Erfahrung
 erprobtes Experten-Netzwerk
 100+ erfolgreiche Kundenprojekte


Crawling
-
 Crawling bedeutet: Googlebot ruft Inhalte deiner Website ab.
-
Prüfe eine konkrete URL und trenne gespeicherten Stand und Live-Test.
-
robots.txt steuert den Abruf. Für noindex muss Google die Regel lesen können.
- Zusammenfassung
- Wie funktioniert Crawling bei Google?
- Woran erkennst du Crawling-Probleme?
- Welche Ursachen solltest du prüfen?
- Wie unterscheiden sich robots.txt und noindex?
- Wann ist das Crawl-Budget relevant?
- Wie oft crawlt Google eine Seite?
- Wie sieht ein Crawling-Fehler im Shop aus?
- Welche Rolle spielt Crawling für GEO und AI Search?
- Wie gehst du jetzt weiter vor?
- Weiterführende Links
- Häufig gestellte Fragen
Crawling ist der automatisierte Abruf von Webseiten durch einen Crawler. Bei Google übernimmt Googlebot diese Aufgabe. Er ruft bekannte URLs und ihre Inhalte ab. Anschließend kann Google die Inhalte weiterverarbeiten und über ihre Aufnahme in den Suchindex entscheiden. Google Search Central beschreibt Crawling und Indexierung als getrennte Schritte der Suche. Quelle
Für deine SEO-Arbeit heißt das: Prüfe zuerst, ob Google deine Seite überhaupt erreichen kann. Ein funktionierender Aufruf in deinem Browser beantwortet diese Frage noch nicht. Googlebot kann etwa an einer Sperre scheitern, die Besucher:innen nicht betrifft.
Wie funktioniert Crawling bei Google?
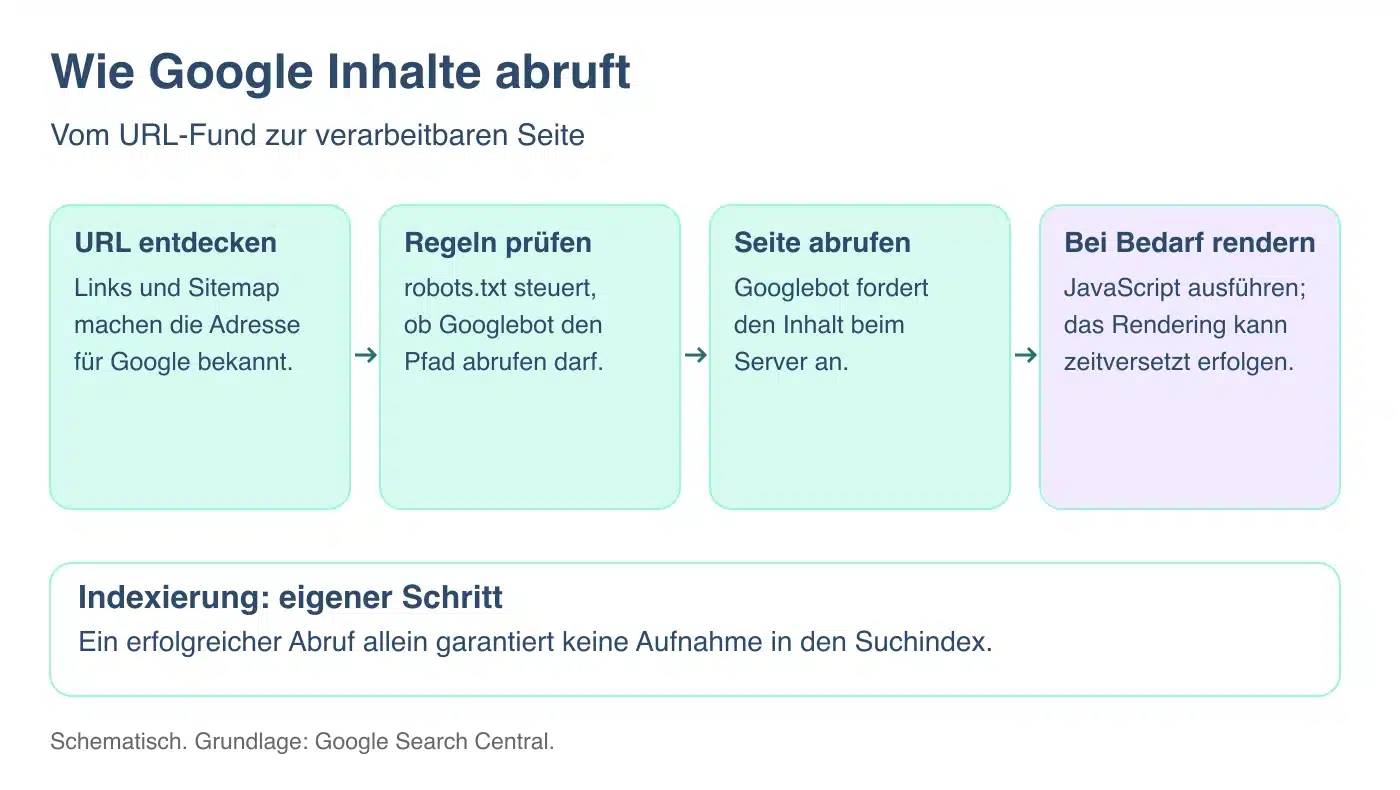
Beim Crawling ruft Googlebot bekannte URLs ab und folgt erreichbaren Links zu weiteren Seiten. Google entdeckt Adressen unter anderem über bereits bekannte Seiten und Sitemaps. Eine neue Seite bekommt deshalb einen nachvollziehbaren Einstieg in deine Website: Verlinke sie aus einem passenden Inhalt oder einer Übersichtsseite. Laut Google sind Links mit einem a-Element und einem href-Attribut zuverlässig crawlbar. Quelle
Vor dem Abruf prüft Googlebot die geltenden robots.txt-Regeln. Erlauben diese den Zugriff, fordert er die Seite vom Server an. Google entscheidet selbst, welche URLs wann abgerufen werden.
Erzeugt JavaScript den Inhalt, kommt Rendering hinzu: Google führt JavaScript aus, um die Seite zu verarbeiten. Das kann zeitversetzt passieren. Prüfe deshalb auch, ob wichtige Texte und Links in der gerenderten Fassung vorhanden sind. Google beschreibt diesen Ablauf in seiner JavaScript-Dokumentation. Ein erfolgreicher Abruf allein bestätigt noch keine Aufnahme in den Suchindex. Die nachfolgende Indexierung ist ein eigener Prüfschritt. Quelle
Woran erkennst du Crawling-Probleme?
Crawling-Probleme erkennst du, indem du den Zugriff auf eine konkrete URL und die dokumentierten Google-Abrufe prüfst. Starte in der Google Search Console mit der vollständigen Adresse. Achte auf Varianten mit Parametern oder Weiterleitungen, damit du tatsächlich die gewünschte Seite untersuchst.
Die URL-Prüfung zeigt dir den gespeicherten Stand bei Google. Kontrolliere den letzten Abruf und Hinweise darauf, ob Crawling erlaubt war und die Seite abgerufen werden konnte. Der Live-Test prüft die aktuell erreichbare Fassung. Google weist darauf hin, dass ein erfolgreicher Live-Test keine bereits erfolgte Indexierung bestätigt. Quelle
Für Entwicklungen auf der gesamten Website nutzt du den Bericht zur Crawling-Statistik. Dort siehst du unter anderem Anfragen, Antwortzeiten und Antwortcodes. Die Beispiel-URLs sind keine vollständige Liste aller Abrufe. Ergänzend können Serverlogs zeigen, welche Adressen angefordert wurden. Ein als Googlebot bezeichneter User-Agent allein belegt dabei noch keinen echten Google-Abruf. Quelle
Notiere zu jedem Befund die URL und den Prüfzeitpunkt. So kannst du nach einer Korrektur vergleichen, was sich tatsächlich geändert hat.
Welche Ursachen solltest du prüfen?
Prüfe bei Crawling-Problemen zuerst Entdeckung, Zugriffsregeln und Serverantworten. Fehlt eine Seite in der Suche, kann die Ursache aber auch erst bei der Indexierung liegen. Die Tabelle hilft dir, diese Fälle zu trennen. Sie ersetzt die Prüfung der konkreten URL nicht.
Auf schmalen Bildschirmen kannst du die Tabelle seitlich verschieben.
| Beobachtung | Mögliche Ursache | Nächster Prüfschritt |
|---|---|---|
| Neue URL bleibt unbekannt | Es fehlen auffindbare Links | Passenden internen Link und Sitemap prüfen |
| Abruf ist durch robots.txt blockiert | Eine Regel sperrt den Pfad | Regel für Googlebot und genaue URL prüfen |
| Zugriff endet mit 403 | Server oder Firewall verweigert den Zugriff | Zugriffsbeschränkung mit der Technik prüfen |
| Antwort ist 404 oder 410 | Die URL liefert keinen vorhandenen Inhalt | Zieladresse und beabsichtigten Status prüfen |
| Server meldet 5xx oder 429 | Serverfehler oder zu viele Anfragen | Verfügbarkeit und Serverlast untersuchen |
| Wichtiger Text fehlt beim Rendering | JavaScript oder Ressourcen sind nicht verfügbar | Gerenderten Inhalt und Ressourcen prüfen |
| Abruf erfolgt, Seite bleibt ausgeschlossen | Ursache kann bei der Indexierung liegen | noindex und kanonische URL prüfen |
Google erläutert die Verarbeitung von Statuscodes in seiner Crawling-Dokumentation. Wiederholte Serverfehler oder 429-Antworten können das Crawling verringern. Ein selbst gewählter Fehlercode ist deshalb kein sinnvoller Ersatz für eine saubere Zugriffsregel. Quelle
Priorisiere bestätigte Fehler auf Seiten, die deine Zielgruppe finden soll. Ändere eine Einstellung erst, wenn du ihren Zweck verstanden hast. Prüfe danach erneut dieselbe URL und dokumentiere das Ergebnis.
Wie unterscheiden sich robots.txt und noindex?
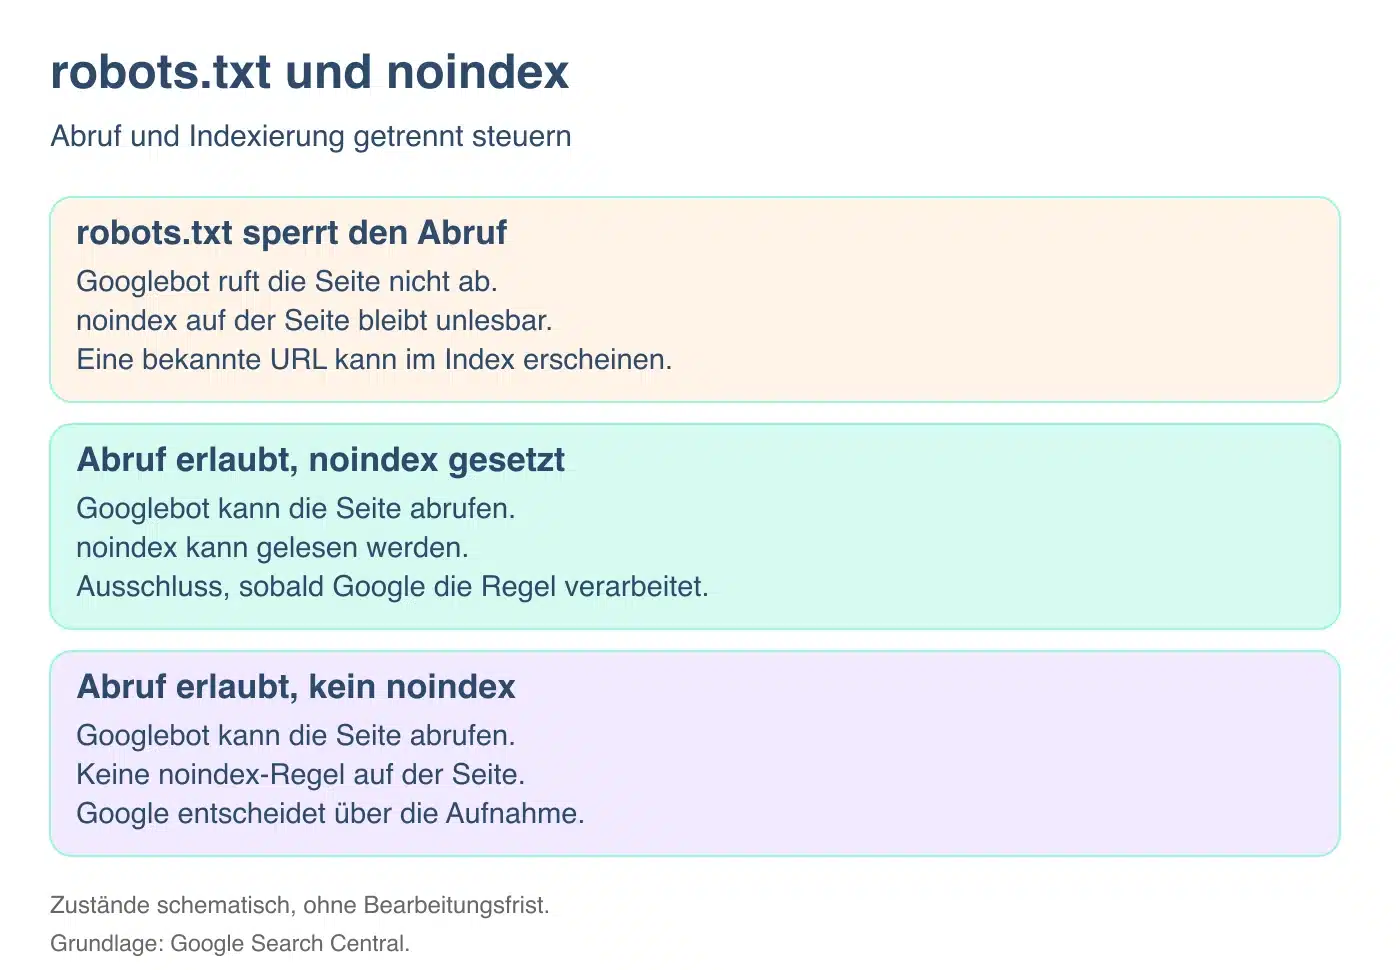
robots.txt steuert den Abruf, noindex die Aufnahme in den Suchindex. Eine robots.txt-Sperre verhindert nicht zuverlässig, dass eine bekannte URL in Suchergebnissen erscheint. Google kann die Adresse etwa über Links kennen, ohne ihren Inhalt abzurufen. Diese Grenze erklärt Google in der Dokumentation zu robots.txt. Quelle
Soll eine Seite aus dem Index bleiben, muss Google eine noindex-Regel lesen können. Sperrst du gleichzeitig ihren Abruf, kann Google die Regel auf der Seite nicht erkennen. Prüfe deshalb zuerst dein Ziel: Möchtest du Abrufe begrenzen oder die Indexierung ausschließen? Google dokumentiert noindex als Meta-Tag und als HTTP-Header. Quelle
Wann ist das Crawl-Budget relevant?
Das Crawl-Budget ist besonders bei großen oder häufig aktualisierten Websites relevant. Google beschreibt damit den Umfang an URLs, den Googlebot crawlen kann und crawlen möchte. Dahinter stehen die verfügbare Crawling-Kapazität und der Crawling-Bedarf.
Prüfe zuerst, ob wichtige neue Inhalte zeitnah entdeckt werden und ob technische Fehler den Abruf behindern. Bei einer überschaubaren Website ohne solche Probleme brauchst du nicht vorsorglich jedes Crawling-Signal zu verändern. Bei großen Shops können sehr viele ähnliche Filter-URLs unnötige Abrufe erzeugen. Google empfiehlt unter anderem, unwichtige Duplikate zu begrenzen und Serverfehler zu beheben. Mehr Abrufe allein garantieren keine bessere Platzierung. Quelle
Wie oft crawlt Google eine Seite?
Google crawlt Seiten ohne einheitlichen Zeitplan. Wie oft eine URL abgerufen wird, hängt unter anderem von Änderungsbedarf und den verfügbaren Serverressourcen ab. Beurteile deshalb die konkrete Seite anhand ihres letzten dokumentierten Abrufs.
Nach einer wichtigen Änderung kannst du in der Search Console die Indexierung beantragen. Google nennt für einen erneuten Abruf wenige Tage bis einige Wochen. Wiederholte Anträge beschleunigen den Vorgang nicht. Eine Sitemap kann helfen, viele geänderte URLs bekannt zu machen. Google garantiert weder den Abruf noch die Aufnahme. Die Dauer bis zur sichtbaren Änderung im Suchergebnis behandelst du getrennt davon. Quelle
Wie sieht ein Crawling-Fehler im Shop aus?
Ein Crawling-Fehler kann eine neue Shop-Kategorie betreffen, obwohl ihr Menülink funktioniert. Ein fiktives Beispiel: Du legst eine Kategorie an und verlinkst sie im Shop. Eine ältere robots.txt-Regel sperrt aber noch den gesamten zugehörigen Pfad für Googlebot.
Prüfe die genaue Kategorie-URL mit der URL-Prüfung und kontrolliere die passende Regel. Soll Google die Seite abrufen, lässt du die versehentliche Sperre korrigieren. Teste danach den aktuellen Zugriff erneut. Halte fest, welche Regel geändert wurde und was der neue Test zeigt. Prüfe anschließend den nächsten regulären Abruf und den Indexstatus getrennt. Das Entfernen der Sperre allein bestätigt noch keine Indexierung der Kategorie.
Welche Rolle spielt Crawling für GEO und AI Search?
Crawling schafft auch für Googles KI-Suchfunktionen den Zugang zu deinen Inhalten. Google nennt Googlebot als Steuerung für die Suche einschließlich AI Overviews und AI Mode. Damit eine Seite dort als unterstützender Link infrage kommt, muss sie indexiert und für ein Snippet geeignet sein. Abrufbarkeit allein erfüllt diese Voraussetzungen noch nicht. Quelle
Prüfe für GEO und AI Search deshalb zuerst die Grundlagen. Schreibe anschließend verständliche, belegte Antworten. Eine garantierte Nennung in KI-Antworten ergibt sich daraus nicht. Regeln für Googlebot lassen sich außerdem nicht pauschal auf die Crawler anderer Anbieter übertragen.
Wie gehst du jetzt weiter vor?
Prüfe eine wichtige URL und dokumentiere den letzten Abruf sowie aktuelle Zugriffshindernisse. Du brauchst Unterstützung bei der Diagnose? In unserer SEO-Beratung ordnen wir den Befund mit dir ein. Schick uns deine URL und deine Frage über das Kontaktformular.
-
 Google: Funktionsweise der Suche
-
Google: Crawlbare Links
-
Google: JavaScript und Rendering
-
Google: URL-Prüfung
-
Google: Crawling-Statistik
-
Google: HTTP-Statuscodes
-
Google: robots.txt
-
Google: noindex
-
Google: Kanonische URLs
-
Google: Crawl-Budget
-
Google: Erneutes Crawling anfordern
-
Google: KI-Suchfunktionen
-
Google: Google-Anfragen verifizieren
-
Google: Sitemaps
Häufig gestellte Fragen
-
Was ist der Unterschied zwischen Crawling und Indexierung?


-
Wie oft besucht Googlebot meine Website?
-
Kann ich Google zum Crawlen auffordern?
-
Verhindert robots.txt die Indexierung einer Seite?
-
Warum funktioniert noindex trotz Einstellung nicht?
-
Kann Google Inhalte aus JavaScript crawlen?
-
Braucht jede Website eine Crawl-Budget-Optimierung?
-
Was unterscheidet die URL-Prüfung von der Crawling-Statistik?
-
Kann eine Firewall Googlebot blockieren?
-
Reicht Crawling für eine Nennung in Googles KI-Antworten?