 15+ Jahre Erfahrung
 erprobtes Experten-Netzwerk
 100+ erfolgreiche Kundenprojekte


robots.txt
-
 Mit robots.txt legst du fest, welche Bereiche Crawler abrufen dürfen. Für den Ausschluss aus dem Index brauchst du eine eigene Anweisung.
-
Bei mehreren passenden Regeln zählt die spezifischste Pfadregel innerhalb der passenden Crawler-Gruppe.
-
Suchnutzung und mögliche Trainingsnutzung kannst du je nach Anbieter getrennt steuern.
- Zusammenfassung
- Wo findest du die robots.txt?
- Wie ist eine robots.txt aufgebaut?
- Welche Regel gilt bei mehreren Treffern?
- Was unterscheidet robots.txt und noindex?
- Wie kannst du deine robots.txt prüfen?
- Wie schnell übernimmt Google Änderungen?
- Was gilt für KI-Crawler und GEO?
- Wie gehst du mit Änderungen um?
- Weiterführende Links
- Häufig gestellte Fragen
Die robots.txt ist eine Textdatei, mit der du festlegst, welche Bereiche deiner Website Crawler abrufen dürfen. Sie gehört zum Robots Exclusion Protocol. Suchmaschinen, die diese Regeln beachten, lesen die Datei vor dem Seitenabruf. Google kann eine gesperrte URL trotzdem in den Suchergebnissen anzeigen. Quelle
Lege zuerst fest, was du erreichen möchtest. Mit der robots.txt steuerst du das Crawling, also den Abruf deiner Inhalte. Um eine Seite aus dem Suchindex zu entfernen, brauchst du eine andere Anweisung, etwa noindex.
Wo findest du die robots.txt?
Du findest die robots.txt im Hauptverzeichnis deiner Website, zum Beispiel unter https://example.com/robots.txt. Google verlangt eine reine Textdatei in UTF-8. Legst du sie in einem Unterordner ab, kann sie die Aufgabe für deine Website nicht erfüllen. Quelle
Die Datei gilt für einen bestimmten Ursprung. Dazu gehören der Hostname, etwa www.example.com, das Protokoll und der Port. Eine Subdomain übernimmt die Regeln der Hauptdomain nicht automatisch. Quelle
Laufen Website und Shop auf unterschiedlichen Hosts, rufe deren jeweilige robots.txt auf. Notiere die geprüfte Adresse. So kannst du die Regeln später dem richtigen Teil deiner Website zuordnen.
Wie ist eine robots.txt aufgebaut?
In der robots.txt ordnest du Pfadregeln einem Crawler oder einer Crawler-Gruppe zu. Mit User-agent benennst du den Crawler. Disallow sperrt einen Pfad, Allow erlaubt einen Pfad beziehungsweise eine Ausnahme von einer Sperre. Über Sitemap gibst du die vollständige Adresse einer Sitemap an. Quelle
Das ist ein fiktives Beispiel. Passe die Pfade und die Sitemap-Adresse an deine Website an, bevor du solche Regeln übernimmst.
User-agent: *
Disallow: /archiv/
Allow: /archiv/hilfe/
Sitemap: https://example.com/sitemap.xml
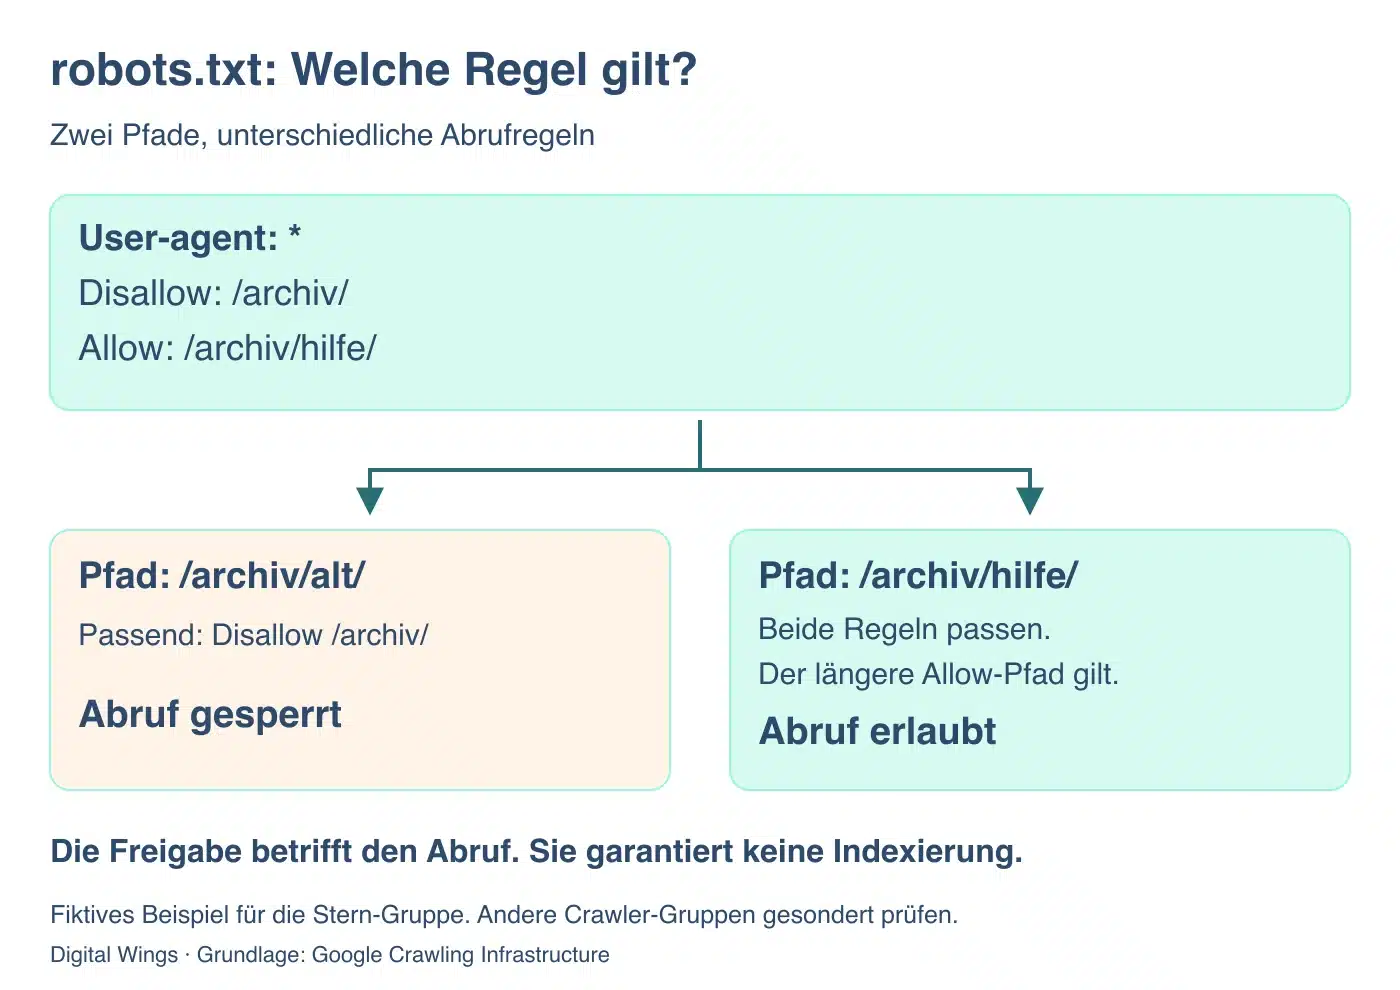
Der Stern steht für Crawler, für die keine spezifischere Gruppe passt. Disallow sperrt hier den Archivbereich. Die längere Allow-Regel erlaubt den Hilfepfad innerhalb dieses Bereichs.
Die Sitemap-Zeile nennt nur den Speicherort der Sitemap. Auch für die darin genannten URLs gelten die Pfadregeln. Eine gesperrte Seite bleibt durch diesen Eintrag gesperrt.
Welche Regel gilt bei mehreren Treffern?
Google wählt innerhalb der passenden Crawler-Gruppe die spezifischste passende Pfadregel. Dafür zählt die Länge des passenden Pfads. Bei gleich spezifischen widersprüchlichen Regeln gilt Allow. Die Reihenfolge der Zeilen gibt einer Regel keinen Vorrang. Quelle
Im Beispiel darf der Crawler /archiv/alt/ nicht abrufen. Für /archiv/hilfe/ greift die längere Allow-Regel. Die Grafik zeigt, wie sich diese Regeln auf den Abruf auswirken. Über die Aufnahme einer Seite in den Index entscheidet Google getrennt davon.
Bei mehreren Gruppen kommt es auch darauf an, welche davon zum Crawler passen. RFC 9309 beschreibt diese Auswahl anhand des User-agents und die Zusammenführung passender Gruppen. Eine spezifische Crawler-Gruppe übernimmt die Regeln der Stern-Gruppe nicht pauschal. Quelle
Teste wichtige Zieladressen daher mit den jeweils betroffenen Crawlern. Dieselbe Adresse kann je nach Bot erlaubt oder gesperrt sein.
Was unterscheidet robots.txt und noindex?
Mit noindex weist du Google an, eine Seite aus dem Suchindex auszuschließen. Dazu muss Google die Seite abrufen und die Anweisung im Meta-Tag oder HTTP-Header lesen können. Eine gleichzeitige robots.txt-Sperre verhindert diesen Abruf. Den Eintrag noindex innerhalb der robots.txt unterstützt Google nicht. Quelle
Soll ein veröffentlichter Inhalt aus den Suchergebnissen verschwinden, prüfst du seine Indexierung und die passende Anweisung. Eine robots.txt-Sperre allein entfernt eine bekannte URL nicht verlässlich aus dem Index.
Vertrauliche Inhalte brauchen einen Zugriffsschutz. Die robots.txt ist öffentlich einsehbar. Wer sie aufruft, kann die dort genannten Verzeichnisse sehen. Der Standard RFC 9309 stellt klar, dass die Datei keine Zugriffskontrolle ersetzt. Quelle
Wie kannst du deine robots.txt prüfen?
Wenn du deine robots.txt prüfen möchtest, sichere zuerst die vorhandene Fassung. Wähle dann für den betroffenen Crawler konkrete Beispiel-URLs aus: Welche soll er abrufen dürfen, welche sollen gesperrt bleiben? Vergleiche das gewünschte Ergebnis mit den Regeln, die dein Server ausliefert.
Im robots.txt-Bericht der Google Search Console siehst du, welche Fassung Google zuletzt abgerufen hat und ob dabei Probleme aufgetreten sind. Für die Prüfung einer einzelnen Seite nutzt du zusätzlich die URL-Prüfung. Quelle
Auf schmalen Bildschirmen kannst du die Tabelle seitlich verschieben.
| Befund | Mögliche Ursache | Nächster Prüfschritt |
|---|---|---|
| Wichtige Seite wird blockiert | Eine Pfadregel trifft mehr URLs als geplant. | Passende Gruppe und vollständigen Zielpfad prüfen. |
| Ausnahme greift nicht | Regel oder Crawler-Gruppe passt nicht zum Ziel. | User-agent und Spezifität der Regeln vergleichen. |
| Datei enthält noindex | Abruf- und Indexierungssteuerung wurden verwechselt. | Gewünschtes Ergebnis und noindex auf der Seite prüfen. |
| Browser und Search Console zeigen verschiedene Inhalte | Google kennt eine ältere Dateifassung. | Abrufzeitpunkt vergleichen und bei wichtiger Korrektur neuen Abruf beantragen. |
| robots.txt liefert einen Serverfehler | Hosting oder Auslieferung funktionieren nicht zuverlässig. | Erreichbarkeit wiederherstellen und Googles Abrufstatus prüfen. |
| Inhalt sieht wie eine Website statt wie Regeln aus | Falsche Datei oder falsche Auslieferung. | Antwortinhalt und Nur-Text-Format kontrollieren. |
Wenn du eine Sperre aufhebst, kontrolliere auch die interne Verlinkung zur Zielseite. Nutzer:innen und Crawler sollen sie über passende Inhalte finden können. Notiere die geänderte Regel und deine Testergebnisse. Mit der gesicherten Fassung kannst du die Änderung bei Bedarf zurücknehmen.
Wie schnell übernimmt Google Änderungen?
Google speichert die robots.txt normalerweise für bis zu 24 Stunden im Cache. Bei Abrufproblemen kann Google länger auf eine gespeicherte Fassung zurückgreifen. Auch Cache-Control-Angaben können die Dauer beeinflussen. Die 24 Stunden sind daher keine garantierte Übernahmefrist. Quelle
Nach einer wichtigen Korrektur kannst du im robots.txt-Bericht einen erneuten Abruf der Datei beantragen. Quelle Prüfe danach zwei Zeitpunkte: Wann hat Google die neue robots.txt geladen? Und wann hat Google die betroffene Seite erneut abgerufen? Die Freigabe löst keinen garantierten sofortigen Seitenabruf aus.
Was gilt für KI-Crawler und GEO?
Für GEO ist relevant, ob ein Anbieter deine Inhalte für seine Suche abrufen darf. Googlebot crawlt für die Google Suche einschließlich ihrer KI-Funktionen. Eine Freigabe ermöglicht den Abruf, garantiert aber keine Auswahl deiner Website als Quelle in einer KI-Antwort. Quelle
Über Google-Extended steuerst du bestimmte Nutzungen für Gemini-Training und Grounding. Diese Einstellung beeinflusst laut Google weder die Aufnahme noch das Ranking in der Google Suche. Für das Crawling der Suche gelten die Googlebot-Regeln. Quelle
OpenAI verwendet OAI-SearchBot für die ChatGPT-Suche und GPTBot für Inhalte, die für Modelltraining infrage kommen. Du kannst die beiden Nutzungen unabhängig voneinander steuern. Quelle
Entscheide vor einer Sperre, welche Nutzung du erlauben möchtest, und gleiche die Bot-Kennungen mit der aktuellen Anbieter-Dokumentation ab. Mit einer pauschalen Sperre kannst du auch Such-Crawler ausschließen, die deine Inhalte finden sollen.
Wie gehst du mit Änderungen um?
Halte fest, welche URLs du freigeben oder sperren möchtest. Kontrolliere nach der Änderung die Regeln und Googles gespeicherte Fassung. Bei unerwarteten Ergebnissen greifst du auf dein Backup zurück.
Du möchtest klären, welche Regeln für deine Website passen? Wir prüfen die Datei im Zusammenhang mit Crawling und Indexierung als Teil der Suchmaschinenoptimierung. Besprich deine Website mit Digital Wings.
-
 Google: robots.txt im Überblick
-
Google: robots.txt erstellen
-
Google: Regeln und Verarbeitung
-
IETF: Robots Exclusion Protocol
-
Google: Indexierung mit noindex steuern
-
Google: robots.txt-Bericht
-
Google: KI-Funktionen der Google Suche
-
Google: Google-Crawler und Google-Extended
-
OpenAI: OpenAI-Crawler
-
Google: Sitemaps im Überblick
Häufig gestellte Fragen
-
Braucht jede Website eine robots.txt?


-
Was bedeutet Disallow: /?
-
Kann ich noindex in die robots.txt schreiben?
-
Gilt die robots.txt auch für Subdomains?
-
Hat die letzte Regel in der Datei Vorrang?
-
Wie lange dauert es, bis Google eine Änderung berücksichtigt?
-
Kann ich Such-Crawler und Trainings-Crawler getrennt steuern?
-
Schützt die robots.txt vertrauliche Inhalte?
-
Reicht ein Sitemap-Eintrag aus, um gesperrte Seiten crawlen zu lassen?
-
Unterstützt Google crawl-delay?